Artículo satélite · Cluster PropTech
Cómo construir modelos predictivos para detectar oportunidades inmobiliarias
Los modelos predictivos inmobiliarios pueden ayudar a estimar precios, tiempos de venta o probabilidad de absorción, pero sólo si el problema está bien definido y los datos representan el mercado donde se aplicarán.
El resultado no es una orden de compra: es una señal con margen de error que permite priorizar casos para una revisión profesional más profunda.
Qué debe predecir un modelo inmobiliario
“Detectar oportunidades” es demasiado amplio para entrenar un modelo. Hace falta convertir esa idea en un resultado observable: precio de cierre, días hasta la venta, probabilidad de colocación o diferencia frente a un rango esperado.
También hay que fijar la unidad de análisis, el territorio, la tipología y el momento de la predicción. Un modelo para departamentos usados en una microzona no debería extrapolarse sin pruebas a casas, galpones o desarrollos.
Cuanto más concreta sea la decisión que se quiere asistir, más fácil será elegir datos, métricas y límites de uso coherentes.
El modelo empieza antes del algoritmo
La primera versión debería apoyarse en una línea base simple. Una mediana por microzona y tipología, o una regresión interpretable, permite saber si un método más complejo realmente agrega valor.
Después se pueden comparar árboles, ensambles u otros modelos, siempre con la misma partición de datos y una métrica vinculada al costo del error. Elegir el algoritmo por popularidad suele invertir el orden del problema.
A diferencia de un sistema de scoring inmobiliario, donde pesos y reglas se fijan de manera explícita, un modelo predictivo aprende relaciones a partir de resultados históricos. Esa diferencia exige más controles sobre muestra, estabilidad e interpretación.
Una oportunidad necesita definición
Una propiedad no se vuelve atractiva porque el modelo estime un valor superior al precio publicado. Esa diferencia puede reflejar datos incompletos, estado no observado, expensas, ocupación, problemas documentales o un cambio reciente del mercado.
La señal sirve para abrir una revisión: comparar evidencia, medir costos y entender por qué el caso se aparta del rango esperado.
Tres capas antes de elegir un algoritmo
La calidad del modelo depende menos de su nombre que de la relación entre objetivo, información disponible y contexto de aplicación.
Objetivo verificable
La variable objetivo debe existir y medirse con una definición estable. Precio publicado no es precio de cierre, y una baja de precio no equivale necesariamente a una venta.
Datos disponibles a tiempo
Superficie, tipología, microzona, estado, antigüedad, fecha y contexto de oferta pueden aportar señal si estaban disponibles antes de decidir y mantienen una calidad comparable.
Regla de uso
Hay que definir quién recibe la predicción, qué umbral activa una revisión, qué casos quedan fuera y qué evidencia adicional se exige antes de actuar.
Cómo validar sin entrenar con el futuro
Si el objetivo es usar el modelo sobre publicaciones nuevas, la validación debe respetar el orden temporal. Se entrena con un período anterior y se prueba con uno posterior, repitiendo el ejercicio en distintas ventanas.
También hay que evitar fugas de información. Una variable calculada después del resultado —como conocer la venta final al construir un indicador previo— puede inflar artificialmente el desempeño y desaparecer cuando el sistema entra en operación.
La evaluación no termina en una métrica global. Conviene medir el error por microzona, tipología, rango de precio y fecha para descubrir segmentos donde la estimación deja de ser confiable.
Controles mínimos del modelo
- Comparar contra una línea base simple y documentada.
- Separar entrenamiento, validación y prueba por fecha.
- Medir error absoluto, relativo y por segmentos relevantes.
- Revisar variables influyentes, datos faltantes y casos atípicos.
- Monitorear cambios de desempeño y definir cuándo recalibrar o detener el uso.
De la predicción a una oportunidad revisable
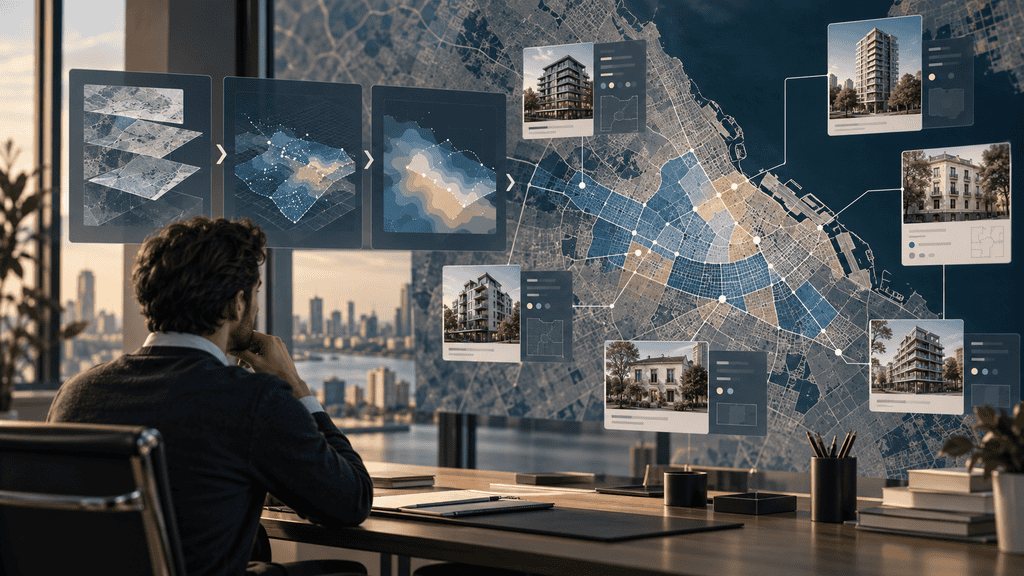
Una estimación puede combinarse con los desvíos de precio en comparables inmobiliarios para ordenar casos, pero el ranking debe mostrar un rango de incertidumbre y las razones que sostienen la señal.
La revisión humana contrasta estado, documentación, costos, liquidez y particularidades del activo. Ese enfoque es coherente con una IA aplicada al análisis inmobiliario como herramienta de asistencia, no como sustituto de la experiencia profesional.
El modelo no descubre una oportunidad por sí solo: reduce una lista y hace visible dónde conviene concentrar la investigación.
Conclusión
Construir modelos predictivos inmobiliarios exige definir una pregunta verificable antes de seleccionar un algoritmo.
La calidad de la muestra, la separación temporal, las métricas por segmento y el control de fugas determinan si una predicción puede sostenerse fuera del conjunto de entrenamiento.
Cuando la salida se presenta con error, cobertura y límites, el modelo puede priorizar análisis sin confundir una señal estadística con una decisión inmobiliaria.